1. 暴力解法
🔍
枚举
遍历所有可能的情况,逐个检查是否满足条件。
⚡
快速排序
将无序数据变为有序,很多问题在有序条件下有更优解。
系统梳理顺序表、链表和树的常见算法思想。
涵盖暴力枚举、快速排序、折半查找、散列表、预处理、多指针法、逆置、树的遍历与并查集等核心方法。
遍历所有可能的情况,逐个检查是否满足条件。
将无序数据变为有序,很多问题在有序条件下有更优解。
void Qsort(int A[], int L, int R){
    if (R < L)		return;                  // 区间内元素个数为0或1,直接递归返回即可
    int i = L, j = R;
    int pivot = A[L];
    while (i < j){
        while(i < j && A[j] >= pivot)	j--;
        while(i < j && A[i] <= pivot)	i++;
        if(i < j)	swap(A[i], A[j]);
    }
    swap(A[L], A[i]);
    Qsort(A, L, i-1);
    Qsort(A, i+1, R);
}只需反转两处比较方向:
while(i < j && A[j] <= pivot)	j--;   // 从右往左找比 pivot 大的
while(i < j && A[i] >= pivot) i++; // 从左往右找比 pivot 小的快排不是万能的!以下场景不能使用:
平均 O(n log n) · 最坏 O(n²) · 空间 O(log n) · 不稳定
以下是几种核心的优化思想。
时间 O(log n)
空间 O(1)
适用:有序顺序表
时间 O(n)
空间 O(m)
适用:数据范围有限
预处理 O(n)
查询 O(1)
适用:频繁区间查询
时间视情况
空间 O(1)
适用:有序线性表
核心要素:有序顺序表 | 时间 O(log n) | 空间 O(1)
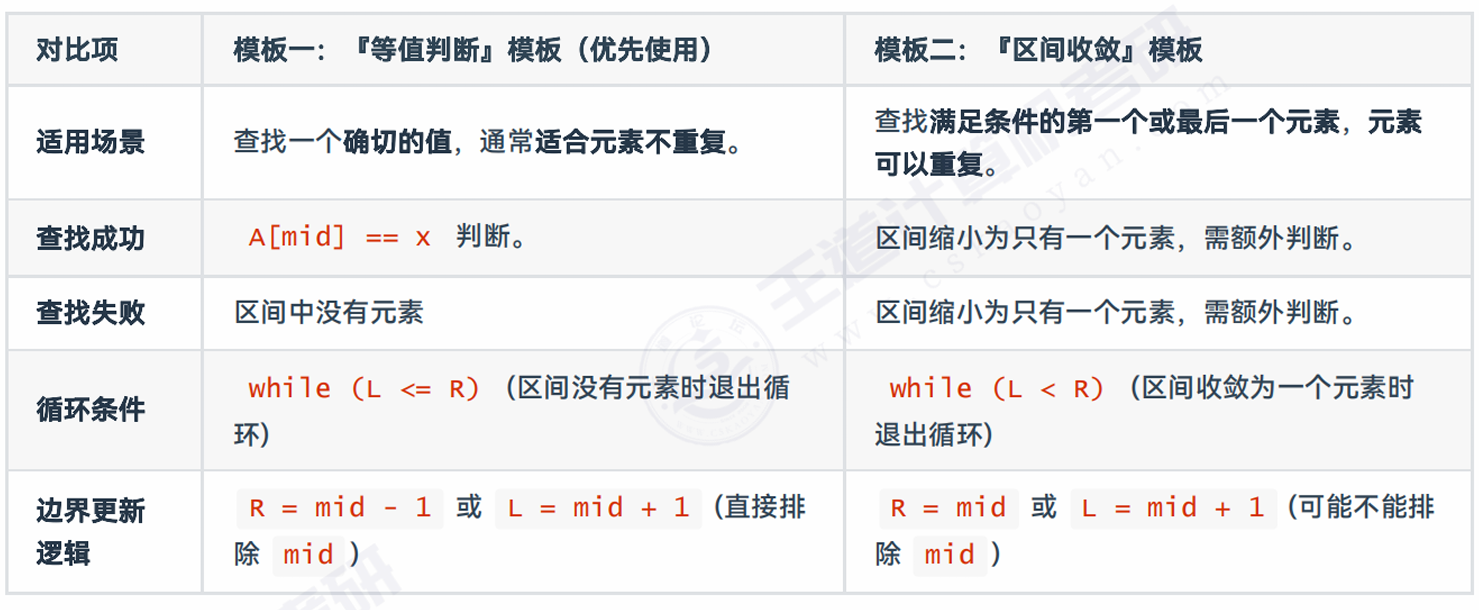
有两种模板。
经典「缩小区间」模式,判断条件为 while (L <= R):
int B_Search(int A[], int L, int R, int x){
    int mid;
    while(L <= R){                       // 只要区间不为空就继续
        mid = (L + R) / 2;
        if(A[mid] == x){
            return mid;                  // 查找成功
        }
        else if (A[mid] > x){
            R = mid - 1;
        }
        else    L = mid + 1;
    }
    return -1;                           // 查找失败
}
通过不断收敛区间来锁定一个边界,判断条件为 while (L < R):
int B_Search(int A[], int L, int R, int x){
    int mid;
    while(L < R){                        // 缩小区间直到只有一个元素
        mid = (L + R) / 2;
        if (A[mid] >= x)	R = mid;     // 第一个符合条件的元素的下标在 L~mid
        else    L = mid + 1;             // 第一个符合条件的元素的下标在 mid+1~R
    }
    return L;                            // 可能成功也可能失败,需额外判断
}
🎯 模板二适用场景
在升序数组中查找第一个等于 x 的元素(数组中可能存在多个 x)。
找到位置 pos 后,需额外判断:return (A[pos] == x) ? pos : -1;
使用条件:数据范围有限 | 时间 O(n) | 空间 O(m)
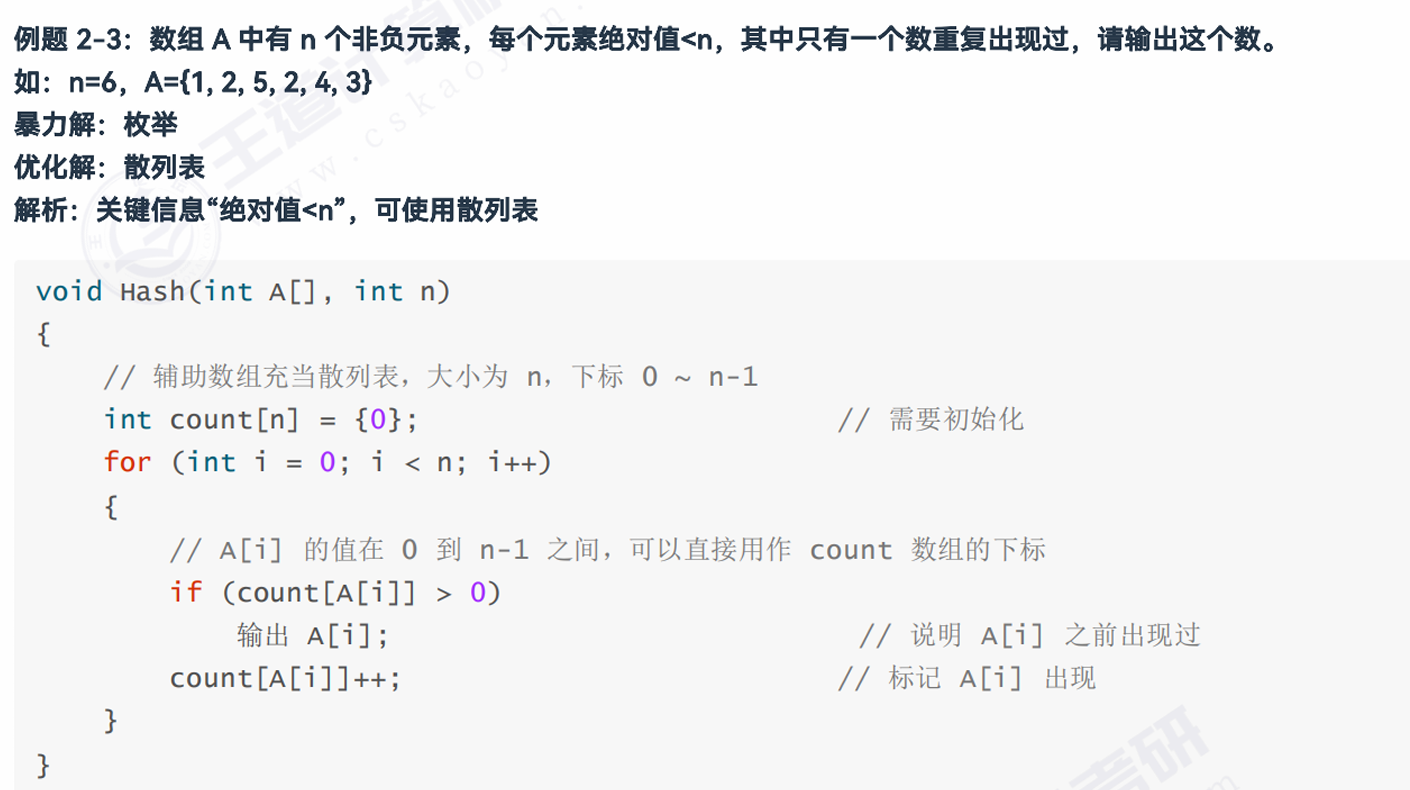
以空间换时间,创建辅助数组 count[],count[i] 用于记录数值 i 出现的相关信息(如次数、是否出现等)。
🎯 什么时候用?
题目明示或通过分析确定元素值的范围时——例如元素值为 0 ~ n-1,或元素绝对值 < n ——马上考虑散列表。
使用条件:频繁区间查询 | 预处理 O(n) | 查询 O(1)
多次查询不同区间的和时,用 O(n) 时间预处理出前缀和数组 sum[],后续每次查询仅需 O(1)。
预处理过程(sum[i] = 前 i 个元素的和,下标范围 0 ~ i-1)
sum[0] = 0
sum[1] = A[0]
sum[2] = A[0] + A[1] = sum[1] + A[1]
sum[3] = A[0] + A[1] + A[2] = sum[2] + A[2]
...
📐 关键公式
区间 [L, R] 的所有元素之和 = sum[R + 1] – sum[L]
📌 例(P2-6):给定含 n 个整数的数组 A,求所有可能的连续子数组的和的最大值。例:n=4, A={1, -2, 3, 5}。
枚举所有子数组:{1}→1, {-2}→-2, {3}→3, {5}→5;{1,-2}→-1, {-2,3}→1, {3,5}→8;{1,-2,3}→2, {-2,3,5}→6;{1,-2,3,5}→7。res 数组为 {5, 8, 6, 7}。
void ans(int A[], int n) {
    // 定义结果数组并初始化
    int res[n];
    for (int i = 0; i < n; i++)
        res[i] = INT_MIN;
    // 定义前缀和数组
    int sum[n + 1] = {0};
    for (int i = 1; i <= n; i++)
        sum[i] = sum[i-1] + A[i-1];
    // 枚举所有区间 [i, j] 并更新
    for (int i = 0; i < n; i++)
        for (int j = i; j < n; j++) {
            int temp = sum[j+1] - sum[i];
            if (temp > res[j-i])
                res[j-i] = temp;
        }
    // 输出 res 数组
}频繁查询区间最大/最小值时,提前维护前缀最值数组。
📌 例(P2-7):给定数组 A,对于每个 j,定义 res[j] = A[0~j] 的最大值 × A[j]。如 A = {3, 1, 2, 7, 6},则 res = {9, 3, 6, 49, 42}。
B[i] 表示 i 下标及之前元素(A[0 ~ i],共 i+1 个元素)的最值void ans(int A[], int n) {
int res[n], B[n];
B[0] = INT_MIN;
for (int i = 0; i < n; i++)
B[i] = max(B[i-1], A[i]);
for (int j = 0; j < n; j++)
res[j] = B[j] * A[j];
// 输出 res 数组
}使用条件:线性表(顺序表、链表),主要是有序线性表 | 时间视情况 | 空间 O(1)
核心思想
在一个或多个线性表上设置两个或多个下标变量(指针),按照特定规则移动它们。
⭐ 「特定规则」就是双指针法的灵魂。
| 要点 | 说明 |
|---|---|
| ① 起始位置 | 从哪里开始 |
| ② 移动规则 | 什么条件下谁移动 |
| ③ 停止处理 | 何时结束 & 收尾工作 |
适用情形:
经典应用:合并多个有序线性表、寻找第 k 个元素、归并排序等。
📌 例 1.1:合并两个升序数组
给定升序数组 A(长度 n)和 B(长度 m),合并成新的升序数组 C 并输出。
| 要点 | 规则 |
|---|---|
| 起始位置 | A、B、C 的指针均从左向右 |
| 移动规则 | 比较 A[pA] 和 B[pB],较小的放入 C,对应指针和 pC 各移一位 |
| 停止处理 | 一方越界即退出;另一数组剩余部分直接追加到 C 末尾 |
📌 例 1.2:平方后降序合并
A 全是负整数(升序),B 全是非负整数(升序)。所有元素平方后按降序排序。
A = {-4, -2} B = {0, 1, 3} → C = {16, 9, 4, 1, 0}
分析:
| 数组 | 原特征 | 平方后 | 最大值位置 |
|---|---|---|---|
| A | 负整数升序 → 绝对值降序 | 降序 | A[0] |
| B | 非负整数升序 → 绝对值升序 | 升序 | B[m-1] |
指针策略:
起始:pA 从左向右 → | pB 从右向左 ← | pC 从左向右 →
移动:比较 A[pA] 和 B[pB] 的绝对值,较大者的平方放入 C,对应指针移动
将单一的表看作从某个「切点」分成的两个逻辑上的有序子序列,指针分别放在各子序列的端点,然后像处理多个有序表一样操作。
🎯 首尾双指针(相向而行)就是这种思想的体现——首尾指针最终会在中间相遇。
📌 e.g.2.1(P2-8):平方后降序排列
含有绝对值的升序数组(如 A={-4, -2, 0, 1, 3}),将所有元素平方后按降序排列,存入新数组 B。
A = {-4, -2, 0, 1, 3} → B = {16, 9, 4, 1, 0}
思路:设置指针 i 在 A[0](绝对值最大端),j 在 A[n-1](绝对值最小端),k 从 B[0] 开始。比较 |A[i]| 与 |A[j]|,较大者的平方放入 B[k],移动对应指针和 k。当一方越界时退出,另一方剩余元素直接追加。
| 要点 | 规则 |
|---|---|
| 起始位置 | i = 0(最左),j = n-1(最右),k = 0 |
| 移动规则 | 比较 |A[i]| 与 |A[j]| → 较大者的平方放入 B[k],对应的 i 或 j 移动,k++ |
| 停止处理 | i > j 时退出,剩余元素依次平方追加到 B 末尾 |
无序情况下的多指针法稍复杂,考频较低。主要用于 Partition(划分) 操作,实际上就是快速排序的一趟划分。
📌 例(P2-9):含 n 个整数的数组 A,以 A[0] 为基准,划分使得左侧全小于 pivot,右侧全大于 pivot。A[0] 不一定是最终位置。如 A={2,5,3,-1,-2} 划分后可能为 {-2,-1,2,3,5} 或 {-1,-2,2,3,5} 等。
void ans(int A[], int n) {
    int i = 0, j = n - 1;
    int pivot = A[0];                // 选第一个元素为基准
    while (i < j) {
        while (i < j && A[j] >= pivot)  j--;   // A[j] < pivot 时停
        while (i < j && A[i] <= pivot)  i++;   // A[i] > pivot 时停
        if (i < j)  swap(A[i], A[j]);          // 交换逆序对
    }
    swap(A[0], A[i]);                // 基准归位
}
扩展:快速排序 vs 快速选择(Quick Select)
| 快速排序 | 快速选择 | |
|---|---|---|
| 目的 | 整个数组有序 | 找第 k 小的元素 |
| 递归 | 两边都递归 | 只递归包含 k 的那一边 |
| 复杂度 | T(n)=2T(n/2)+O(n) → O(n log n) | T(n)=T(n/2)+O(n) → O(n) |
核心技巧:选取 pivot 时尽量接近 n/2 位置,从而在期望 O(n) 时间内找到第 k 小元素。注意区分"以 A[0] 为基准划分"(P2-9)和"快速选择算法"(P2-10)。
| 共同点 | 不同点 | |
|---|---|---|
| 结论 | 都是线性表。顺序表的很多方法在链表中仍然可以使用:散列表、多指针法、预处理(主要前两者) | 链表不可随机访问,快排、折半查找不能用;单链表只能单向访问,需要掌握快慢指针、头插法等技巧 |
📋 做题推荐流程
data 为结点权值(一般可定义成 int),next 指向下一个结点
typedef struct LNode{
    ElemType data;                // 该结点的权值
    struct LNode *next;           // next 指向下一个结点
};prior 指向上一个结点,next 指向下一个
typedef struct LNode{
    ElemType data;                // 该结点的权值
    struct LNode *prior, *next;   // prior 指向上一个结点
};删除时注意两个问题:① 删除操作不要导致断链;② 要能找到下一次待处理的结点(p 要更新所指结点)。
pre->next = p->next;             // 将 pre 的 next 域指向 p 的下一个结点
p = p->next; // 将 p 指向 p 的下一个结点删除时还需考虑释放结点所占内存(C 语言调用 free(p)),考试中为了方便不写也没关系。
加上 free 的写法:
pre->next = p->next;
LNode* temp = p;
p = p->next;
free(temp);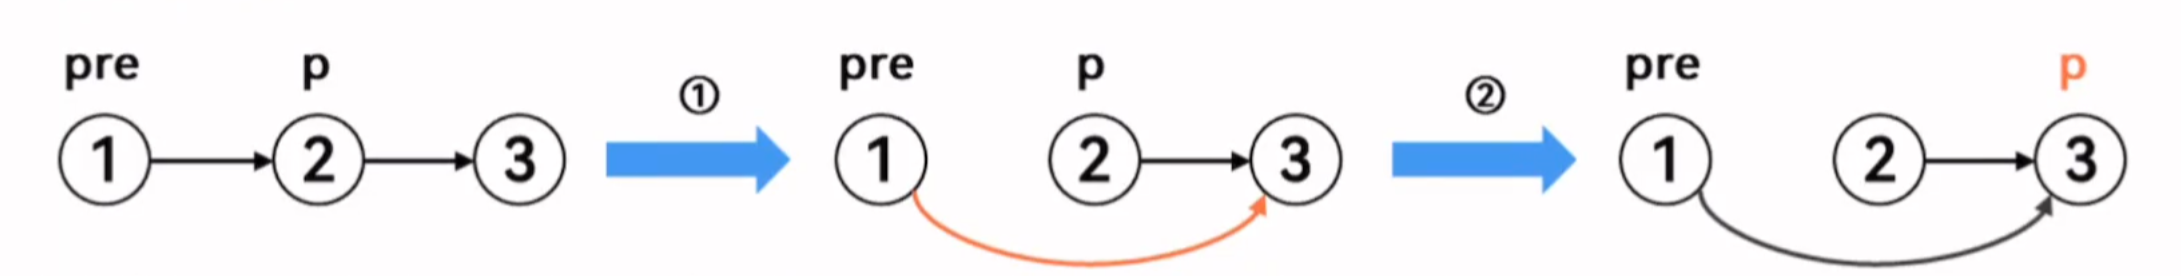
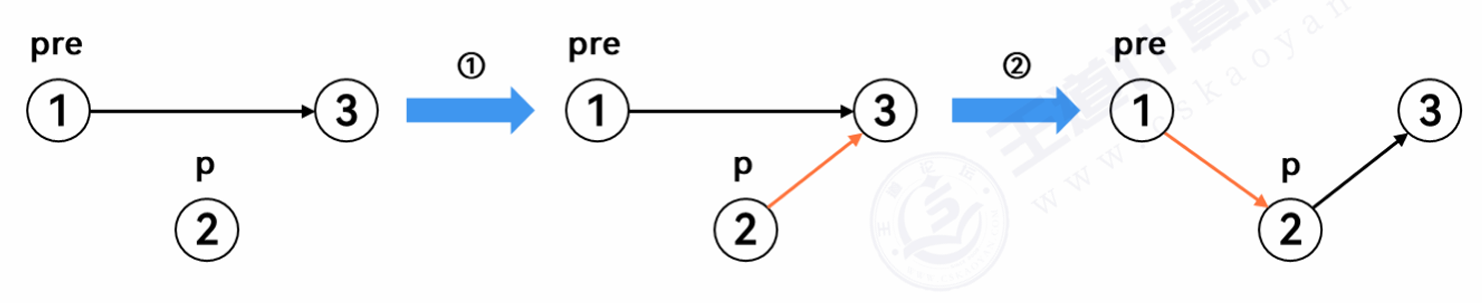
⚠️ 先后再前,这样一定不会断链!
p->next = pre->next;             // 先处理 p 的 next
pre->next = p;                   // 后处理 pre 的 next
先修改 pre 的 next 可能会找不到 pre 的下一个结点。
📥 尾插法
需要保证插入顺序与最终顺序一致时使用。设置 tail 指针始终指向链表末尾。核心三行:
p->next = NULL;                    // ① 将新结点的 next 置为 NULL
tail->next = p;                    // ② 将 tail 的 next 指向 p
tail = p;                          // ③ 更新 tail 为 p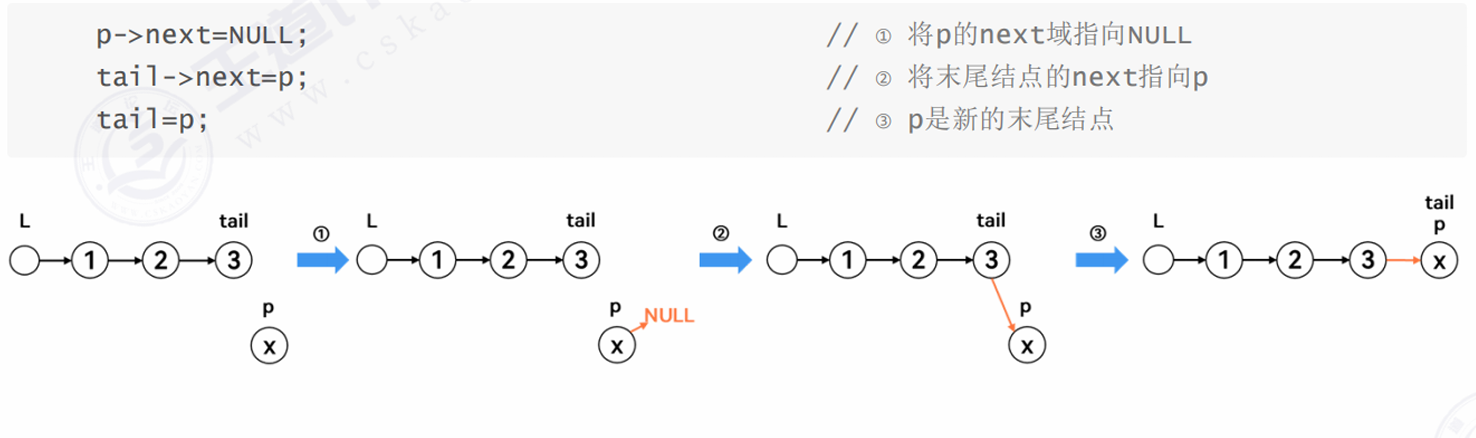
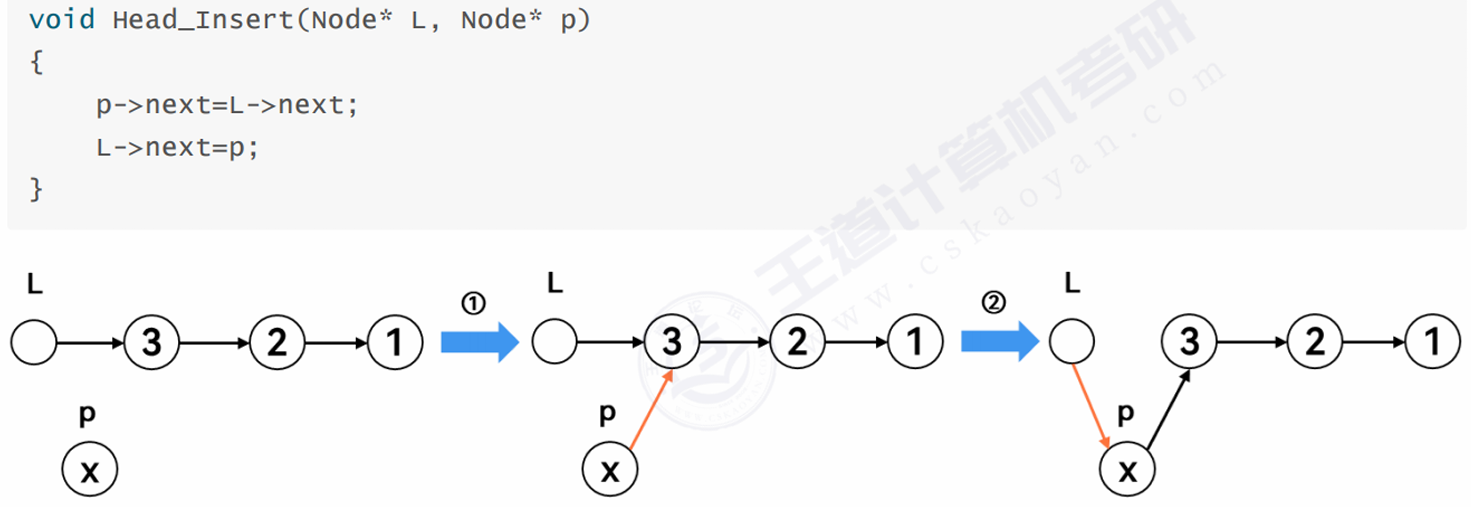
📤 头插法
想让插入顺序与最终顺序相反时使用。将结点插入到头结点和第一个数据结点之间,常用于链表逆置。
void Head_Insert(Node* L, Node* p) {
    p->next = L->next;               // 先连后
    L->next = p;                     // 再连前
}
若表中元素确定就用 for 循环,否则用 while 循环。遍历中访问指针 p 每次都要后移(p = p->next)。链表一般是带头结点的,因此从 L->next 开始。
已知长度 n,for 循环:
Node* p = L->next;
for (int i = 0; i < n; i++) {
    visit(p);                       // 访问 p 结点
    p = p->next;
}
未知长度,while 循环:
Node* p = L->next;
while (p != NULL) {
    visit(p);                       // 访问 p 结点
    p = p->next;
}遍历同时还可以统计元素个数 n:
Node* p = L->next;
int n = 0;
while (p != NULL) {
    n++;
    visit(p);                       // 访问 p 结点
    p = p->next;
}for (Node* p = L->next; p != NULL; p = p->next) visit(p);
例如要改变链表元素顺序,可将需重排的元素一个一个拆下来重新插入。空间复杂度 O(1)。
使用数组保存链表中的数据值,再按照数组的做题方法处理。需要额外 O(n) 空间。
📌 例题:将链表 L 按照升序重新排序,结点结构为 data | next(带头结点单链表)
暴力解 1:逐个拆下重插
// 在有序链表中找到 p 的插入位置并插入
void Find_Insert(ListNode *pre, ListNode *p) {
    while (pre->next!=NULL && pre->next->data < p->data)
        pre = pre->next;
    p->next = pre->next;
    pre->next = p;
}
Node* ans(Node *L) {
    Node *p = L->next;
    L->next = NULL;
    while (p != NULL) {
        Node *temp = p->next;        // 暂存下一个
        Find_Insert(L, p);           // 将 p 插入到 L 中
        p = temp;                    // 处理下一个
    }
    return L;
}
暴力解 2:转数组排序
void Qsort(int A[], int L, int R) {
    if (L >= R) return;
    int pivot, i = L, j = R;
    pivot = A[L];
    while (i < j) {
        while (i < j && A[j] >= pivot) j--;
        while (i < j && A[i] <= pivot) i++;
        if (i < j) swap(A[i], A[j]);
    }
    swap(A[L], A[i]);
    Qsort(A, L, i-1);
    Qsort(A, i+1, R);
}
Node* ans(Node *L) {
    int a[maxn], n = 0;
    Node *p = L->next;
    while (p != NULL) {              // 遍历保存到数组
        a[n] = p->data;  n++;
        p = p->next;
    }
    Qsort(a, 0, n-1);                // 数组排序
    p = L->next;
    for (int i = 0; i < n; i++) {    // 写回链表
        p->data = a[i];
        p = p->next;
    }
    return L;
}顺序表中多指针法有三种情形,但单链表只能从前往后访问,因此只考虑第一种(多个有序链表)。此外,链表自身有特殊用法:快慢指针、前后指针。
归并两个带头结点的升序链表,代码如下:
// 归并两个升序链表
void Merge(LNode *L1, *L2) {
    // p 和 q 分别指向两个链表的第一个数据结点
    LNode *p = L1->next;
    LNode *q = L2->next;
    // 新建一个链表 L3,tail 指向其尾结点
    LNode *L3 = (LNode *)malloc(sizeof(LNode));
    LNode *tail = L3;
    // 合并过程,比较并链接
    while (p != NULL && q != NULL) {
        if (p->data <= q->data) {
            tail->next = p;
            p = p->next;
        } else {
            tail->next = q;
            q = q->next;
        }
        tail = tail->next;           // tail 始终指向尾结点
    }
    // 处理剩余结点,直接链接到 tail 后面
    if (p != NULL) tail->next = p;
    else tail->next = q;
    // 释放旧头结点,返回新链表
    free(L1);  free(L2);
    return L3;
}| 要点 | 规则 |
|---|---|
| 起始位置 | p = L1->next,q = L2->next(跳过各自头结点) |
| 移动规则 | 较小的结点链入 L3,对应指针后移,tail 始终指向尾结点 |
| 停止处理 | 一方遍历完毕,另一方剩余部分直接链接到 tail 后面 |
设置两个指针 p 和 q,初始时都指向第 1 个结点,每次 p 后移 1 次,q 后移 2 次。
判断链表是否有环:
Node *p, *q;
p = q = L->next;
while (p != NULL && q != NULL) {
    p = p->next;                     // p 走 1 步
    q = q->next;
    if (q == NULL) break;
    q = q->next;                     // q 走 2 步
    if (p == q) { /* 有环 */ }
}
求链表的中点:
q 走到终点时(步长是 p 的 2 倍),p 正好在表的中点。求得中点后可将链表一分为二(用另一个新指针指向 p->next,再令 p->next = NULL)。
Node *p, *q;
p = q = L->next;
while (p != NULL && q != NULL) {
    q = q->next;
    if (q == NULL || q->next == NULL) break;
    q = q->next;                     // q 走 2 步
    p = p->next;                     // p 走 1 步
    if (p == q) { /* 有环 */ }
}
// p 就是 q 的一半(即在中点)因单链表只能按一个方向处理,设置两个指针 p 和 q,初始时 p 指向 L,q 指向第 k 个结点。然后 p 和 q 每次同时后移,始终保持 k 的距离。当 q 指向 NULL 时,p 指向倒数第 k 个元素。
经典考题:2009 年真题 #15——查找链表中倒数第 k 个结点。
Node *p, *q;
p = q = L;
for (int i = 0; i < k; i++)
    q = q->next;                     // q 先走 k 步
while (q != NULL) {
    p = p->next;                     // p、q 同步后移
    q = q->next;
}
// 此时 p 指向倒数第 k 个
和数组中一样,额外定义数组保存中间过程。如 count[n] 表示权值为 n 的元素出现次数。
例(P2-3):n=6, A={1, 2, 5, 2, 4, 3},用散列表找出重复元素。
// 链表版
void Hash_Linklist(Node* L) {
    int count[n] = {0};
    Node* p = L->next;
    while (p != NULL) {
        if (count[p->data] > 0)
            cout << p->data;         // 输出重复元素
        count[p->data]++;            // 记录 p->data 出现的次数
        p = p->next;
    }
}
// 顺序表版(对照)
void Hash_Sequence(int a[], int n) {
    int count[n] = {0};
    for (int i = 0; i < n; i++) {
        if (count[a[i]] > 0)
            cout << a[i];            // 输出重复元素
        count[a[i]]++;               // 记录 a[i] 出现的次数
    }
}逆置即将线性表反转,顺序完全反过来。
首尾元素依次交换:A[0]↔A[n-1]、A[1]↔A[n-2]……时间 O(n),空间 O(1)。
for (int i = 0; i < n/2; i++)
swap(A[i], A[n-i-1]);借助头插法逐个重新插入(头插法的特点是后插入的先访问,从而实现反转)。
// 头插辅助函数
ListNode* Head_Insert(ListNode* L, ListNode* p) {
    ListNode* temp = p->next;        // 暂存 p 的下一个结点
    p->next = L->next;               // 先连后
    L->next = p;                     // 再连前
    return temp;                     // 返回 p 的下一个结点
}
void Reverse(ListNode* L) {          // 原地逆置
    ListNode* p = L->next;
    L->next = NULL;
    while (p != NULL)
        p = Head_Insert(L, p);       // 删 p,头插——重复此过程
}📌 2019 年 408 真题 #41(13 分)
题目:设线性表 L=(a₁, a₂, a₃, …, aₙ₋₁, aₙ) 采用带头结点的单链表保存,链表结点定义如下。请设计一个空间复杂度 O(1) 且时间上尽可能高效的算法,重新排列 L 中各结点,得到线性表 L'=(a₁, aₙ, a₂, aₙ₋₁, a₃, aₙ₋₂, …)。
typedef struct node {
    int data;
    struct node* next;
} NODE;
要求:(1) 描述算法设计思想;(2) 写出代码;(3) 分析时间复杂度。
解法一:暴力插入(O(n²) / O(1))
思想:① 遍历得长度 n;② 找到第 (n+1)/2 个结点作为中点,断链分为前后两半;③ 依次将后半段的每个结点插入到前半段的对应位置。
void ans(Node* L) {
    Node *p = L->next;
    int n = 0;
    while (p != NULL) { n++; p = p->next; }  // ① 求表长

    // ② 找到后半段的起点,p 先走一半
    p = L;
    for (int i = 0; i < (n+1)/2; i++)
        p = p->next;

    Node *temp = p;
    p = p->next;
    temp->next = NULL;                       // 前半段收尾

    // ③ 将后半段结点逐个插入前半段
    for (int i = 0; i < n/2; i++) {
        temp = p->next;
        Node *pre = L;
        for (int j = 0; j < n/2-i; j++)      // 找插入位置
            pre = pre->next;
        p->next = pre->next;
        pre->next = p;
        p = temp;                            // p 更新为下一个待处理结点
    }
}
// 时间复杂度:O(n²)
解法二:快慢指针 + 逆置 + 合并(O(n) / O(1))
思想:① 快慢指针找中点;② 后半段逆置(头插法);③ 将逆置后的后半段穿插合并到前半段。
// 头插法
void Head_Insert(Node* L, Node* p) {
    p->next = L->next;
    L->next = p;
}

void ans(Node* L) {
    // ① 快慢指针找中点
    Node *p, *q;
    p = q = L->next;
    while (p != NULL && q != NULL) {
        q = q->next;
        if (q == NULL || q->next == NULL) break;
        q = q->next;
        p = p->next;
    }
    // 此时 p 在中点,将前后断开
    Node *temp = p;
    p = p->next;
    temp->next = NULL;

    // ② 后半段逆置(头插法)
    Node *L2 = (Node*)malloc(sizeof(Node));
    L2->next = NULL;
    while (p != NULL) {
        temp = p->next;
        Head_Insert(L2, p);
        p = temp;
    }

    Node *p1 = L->next;
    Node *p2 = L2->next;

    // ③ 穿插合并
    while (p2 != NULL) {
        // p1 和 p2 各取一个结点
        Node* temp1 = p1->next;
        Node* temp2 = p2->next;
        // p2 插入到 p1 之后
        p2->next = p1->next;
        p1->next = p2;
        // 更新 p1 和 p2
        p1 = temp1;
        p2 = temp2;
    }
}
// 时间复杂度:O(n)① 孩子兄弟表示法
firstchild 指向该结点的第一个孩子,nextbro 指向下一个兄弟。
typedef struct TNode{
    ElemType data;                  // 该结点的权值
    struct TNode *firstchild, *nextbro;   // firstchild 指向第一个孩子,nextbro 指向下一个兄弟
}TNode;
② 双亲表示法(常用于并查集)
一般采用数组存储,father 数组保存每个结点的父亲结点在数组中的下标;也可以定义结构体。
数组存储方式:
int father[MAX_SIZE]; // 保存每个结点的父亲结点下标结构体存储方式:
typedef struct TNode{
    ElemType data;             // 该结点的权值
    struct TNode *father;      // father 指向父结点
}TNode;① 二叉链表
typedef struct BTNode{
    ElemType data;                   // 该结点的权值
    struct BTNode *lchild, *rchild;  // lchild 指向左孩子,rchild 指向右孩子
}BTNode;
② 顺序存储(完全二叉树)
对完全二叉树,从根起按层序存储即可:依次自上而下、自左至右存储结点元素,即将编号为 i 的结点存在数组下标 i-1 的位置;可以用 -1 或 0 表示对应结点不存在。
typedef struct{
    int SqBiTNode[MAX_SIZE];   // 一维数组保存二叉树结点
    int ElemNum;               // 结点个数
}SqBiTree;先、中、后序的递归遍历时间复杂度 O(n),空间复杂度 O(h)(n 为总结点数,h 为树高);若不确定树高,空间复杂度视为 O(n)。
先序遍历(根 → 左 → 右)
void PreOrder(BTNode *p){
    if (p == NULL) return;
    visit(p);                // 先访问根
    PreOrder(p->lchild);
    PreOrder(p->rchild);
}
中序遍历(左 → 根 → 右)
void InOrder(BTNode *p){
    if (p == NULL) return;
    InOrder(p->lchild);
    visit(p);                // 中间访问根
    InOrder(p->rchild);
}
后序遍历(左 → 右 → 根)
void PostOrder(BTNode *p){
    if (p == NULL) return;
    PostOrder(p->lchild);
    PostOrder(p->rchild);
    visit(p);                // 最后访问根
}本质是对孩子兄弟表示法结构的递归操作,重点记住 「左孩子右兄弟」,可转化为"二叉树"模型来理解递归逻辑:
先根遍历(先访问根,再访问孩子)
void TreePreOrder(TNode *T){
    if (T == NULL) return;
    visit(T);                     // 先访问根结点
    TreePreOrder(T->firstchild);  // 再遍历第一个孩子的整棵子树
    TreePreOrder(T->nextbro);     // 最后遍历下一个兄弟的子树
}
后根遍历(孩子访问完再访问根)
void TreePostOrder(TNode *T){
    if (T == NULL) return;
    TreePostOrder(T->firstchild);  // 先遍历第一个孩子的整棵子树
    visit(T);                      // 再访问根结点
    TreePostOrder(T->nextbro);     // 最后遍历下一个兄弟的子树
}
408 中树算法考察的核心是树的遍历,因此应先确定选择哪种遍历方式,以对应遍历作为框架,把 visit(p) 改造成题目要求的功能。
🧭 具体做题步骤
visit(p) 的实现
visit(p) 需要根据题目要求自定义实现:通过处理当前结点 p,用全局变量(累加、计数、状态标记)或函数返回值(自底向上传递信息)来统计结果。
例题 4-1:判断结点 p 是否为叶结点
int leaf_count = 0;),逻辑即检查当前结点是否为叶结点,若是则 leaf_count++。例题 4-2:求树的深度
1 + max(左子树高度, 右子树高度),因此必须先知道左右子树的深度。这是自底向上的过程,需要用后序遍历。例题 4-3:判断是否为完全二叉树
bool leaf = false;③ 循环直至队列为空:结点 p 出队,若 leaf 为 true 但 p 却有子结点,则该树不是完全二叉树,返回 false;若 p 有右孩子而无左孩子,直接返回 false;若 p 只有左孩子或无孩子,设 leaf 为 true;将 p 的非空子结点入队。④ 循环正常结束,返回 true。例题 4-4:判断是否为二叉排序树 BST
pre_value 记录中序遍历中"上一个"被访问的值。① 初始化 pre_value = INT_MIN;② 进行中序遍历;③ visit(p) 比较当前 p->value 与 pre_value,若 p->value <= pre_value 则不满足递增性质,非 BST,返回 false;若满足则更新 pre_value = p->value 后继续遍历;④ 整个遍历成功则返回 true。例题 4-5:森林中找叶结点
例题 4-6:判断是否为 AVL 平衡二叉树
-1)作为标记。📋 总结:各类例题的遍历选择
| 例题 | 问题 | 遍历方式 | 信息传递 |
|---|---|---|---|
| 4-1 | 判断叶结点 | 前 / 中 / 后序均可 | 全局变量 |
| 4-2 | 求树的深度 | 后序(自底向上) | 函数返回值 |
| 4-3 | 判断完全二叉树 | 层序遍历 | 队列 + 标志位 |
| 4-4 | 判断 BST | 中序(递增性质) | 全局变量 pre_value |
| 4-5 | 森林找叶结点 | 前 / 中 / 后序均可 | 全局变量(同 4-1) |
| 4-6 | 判断 AVL | 后序(需子树高度) | 函数返回值(-1 标记) |
💡 补充:带权路径长度 WPL 的两种统计方式
很多时候题目需要我们统计信息,可采用函数返回值或全局变量的方式,有时候两种都可以。以计算二叉树带权路径长度为例:WPL = Σ(叶结点权值 Wi × 该结点深度 Di)。
① 全局变量(遍历中"收集"信息)
核心思想:定义在所有递归调用中共享的变量,遍历任意一步满足条件就直接修改它。适用场景:全局的累加、计数或状态标记。
int WPL = 0;                         // WPL 全局变量
void PreOrder(BTNode *p, int depth){ // 传入结点 p,附带深度 depth
    if (p == NULL) return;           // 空结点直接返回
    // visit(p);
    if (p->lchild == NULL && p->rchild == NULL)  // 叶结点
        WPL += depth * p->weight;    // 累加 深度×权值
    PreOrder(p->lchild, depth+1);    // 递归左子树
    PreOrder(p->rchild, depth+1);    // 递归右子树
}
② 函数返回值(自底向上传递)
核心思想:子问题的解(子树递归调用)通过 return 返回给父问题,父问题利用返回结果计算自己的解。适用场景:返回值表示以该子树为核心的二叉树对应值。
int postOrder(BTNode *p, int depth){ // 传入结点 p,附带深度 depth
    if (p == NULL) return 0;         // 空结点返回 0
    int L_WPL = postOrder(p->lchild, depth+1);  // 左子树 WPL
    int R_WPL = postOrder(p->rchild, depth+1);  // 右子树 WPL
    // visit(p);
    if (p->lchild == NULL && p->rchild == NULL) // 叶结点
        return depth * p->weight;    // 返回 深度×权值
    else
        return L_WPL + R_WPL;        // 返回左右子树 WPL 之和
}BTNode *left = PostOrder(...); BTNode *right = PostOrder(...);,然后 visit(p) 要用到 left 与 right 的值。
并查集是一种高效支持"集合合并"与"查找代表元"的数据结构,常用于处理图中连通性判断、集合合并问题,例如判断是否构成树、求连通块数量、判断环等。
常用双亲表示法定义:用数组 father[] 存储每个元素的"父结点"(其实是祖先结点),形成森林结构。通常将 father[] 定义成全局变量以方便使用。
int father[MAXN]; // father[i] 表示 i 的父结点(祖先)find(x) —— 查找根结点(路径压缩)
查找下标为 x 的结点所在的树根下标;路径压缩:把查找途中所有结点全部变成根结点的儿子,减少树的高度。
// 查找根结点(含路径压缩)
int find(int x){
    if (father[x] != x)
        father[x] = find(father[x]);
    return father[x];
}
Union(x, y) —— 合并两棵树
将下标为 x、y 的结点所在的树合并。
// 合并两个集合
void Union(int x, int y){
    int fx = find(x);
    int fy = find(y);
    if (fx != fy)
        father[fy] = fx;   // 将 fy 的根指向 fx
}union 是 C++ 关键字,实际编译中不能直接用作函数名,考试书写时建议写成 Union。
📌 例题:层次遍历(BFS)求带权路径长度
二叉树结点定义如下,每个结点权值为 1:
typedef struct BTNode{
    int data;
    struct BTNode *lchild, *rchild;
}BTNode;
(1) 按照二叉树的层次遍历 BFS 设计算法,求二叉树的带权路径长度。
(2) 用 C/C++ 写出代码并给出注释。
(3) 分析算法的时间复杂度和空间复杂度。
💡 思路
front 保存队头下标,rear 保存队尾下标,last 表示上一层最后一个元素的下标。rear - front。int ans(BTNode *T){
BTNode* q[MAX_SIZE]; // 循环队列
int front = 0, rear = 0, depth = 1;
int last = 0; // 本层最后一个元素的下标
if (T != NULL) q[rear++] = T; // 根结点入队
BTNode *p; // 当前出队结点
int sum = 1 * 1; // 初始化第一层的贡献:1 个结点 × 深度 1
while (front < rear){
p = q[front++]; // 出队
if (p->lchild != NULL)
q[rear++] = p->lchild;
if (p->rchild != NULL)
q[rear++] = p->rchild;
if (front > last){ // 本层访问结束
depth++;
printf("%d %d %d\n", front, rear, depth);
sum += (rear - front) * depth; // 下一层的结点数 × 新深度
last = rear - 1; // 更新本层末尾哨兵
}
}
return sum;
}if (front > last) 刚成立时,此时 rear - front 保存的是下一层的结点个数,但 depth 仍是上一层的,故需先进行 depth++。手动模拟:根结点入队后 front=0, rear=1,本层末尾哨兵 last = rear-1 = 0;进入 while 循环,根出队 front=1,两个子结点入队 rear=3,此时 front > last 成立,rear-front=2 即第二层结点数,故 depth++ 变为 2,再更新 sum(已提前设 sum=1 把第一层算出来了)。
若一个图中没有自环和重边,它被称为简单图,考试中的图默认简单图。
📐 符号约定
本章默认:图的顶点集合为 V,顶点数 |V| 为 n;
边集合为 E,边数 |E| 为 e。
| 术语 | 含义 |
|---|---|
| 路径 | 从一个顶点到另一个顶点所经过的一系列边的集合。从家里(起点)出发,经过几条街道(边),最终到达学校(终点),这一整段路程就是一条路径。 |
| 环(回路) | 一条特殊的路径,它的起点和终点是同一个顶点。 |
| 自环 | 一条从某个顶点出发,又立刻回到自身的边。 |
| 重边 | 在两个相同的顶点之间,存在多于一条的边。 |
| 无向图 | 图中的边(道路)没有方向,是双向的。 |
| 有向图 | 图中的边(道路)有明确的方向,是单行道。 |
| 无权图 | 所有的边都没有「权重」或「成本」的概念。只关心两个顶点之间有没有路,不关心路有多长。就像地铁线路图,只关心从 A 站到 B 站要经过几站,不关心每站之间的具体距离。 |
| 有权图 | 每一条边都被赋予了一个数值,称为权重。连接两个城市的道路不仅存在,还标有长度(公里),这就是边的权重。 |
| 连通图 | 在一个无向图中,任意两个顶点之间都存在路径。 |
| 强连通图 | 在一个有向图中,任意两个顶点之间都存在路径。 |
| 完全图 | 在一个无向图中,任意两个顶点之间都存在边。 |
| 有向完全图 | 在一个有向图中,任意两个顶点之间都存在边。 |
| 子图 | 从原图中选取一部分顶点和一部分边组成的图。好比你从一张完整的全国地图中,单独把「长三角地区」的地图拎出来。 |
| 极大连通子图 | 在保持「连通」这个性质的前提下,规模最大的子图。你不能再从原图中添加任何顶点或边到这个子图里,否则它就不再是连通的了。就是一个连通分量。 |
| 连通分量 | 对于一个非连通的无向图,图中「抱团」的、内部任意互通的极大连通子图。 |
| 生成树 | 在一个连通图中,选取一部分边,刚好能连接起所有的顶点,并且不形成任何环。这个由「最少的边」构成的骨架,就是一棵生成树。 |
| 邻接矩阵 | 邻接表 | 邻接多重表 | 十字链表 | |
|---|---|---|---|---|
| 有向图 | ✓ | ✓ | ✗ | ✓ |
| 无向图 | ✓ | ✓ | ✓ | ✗ |
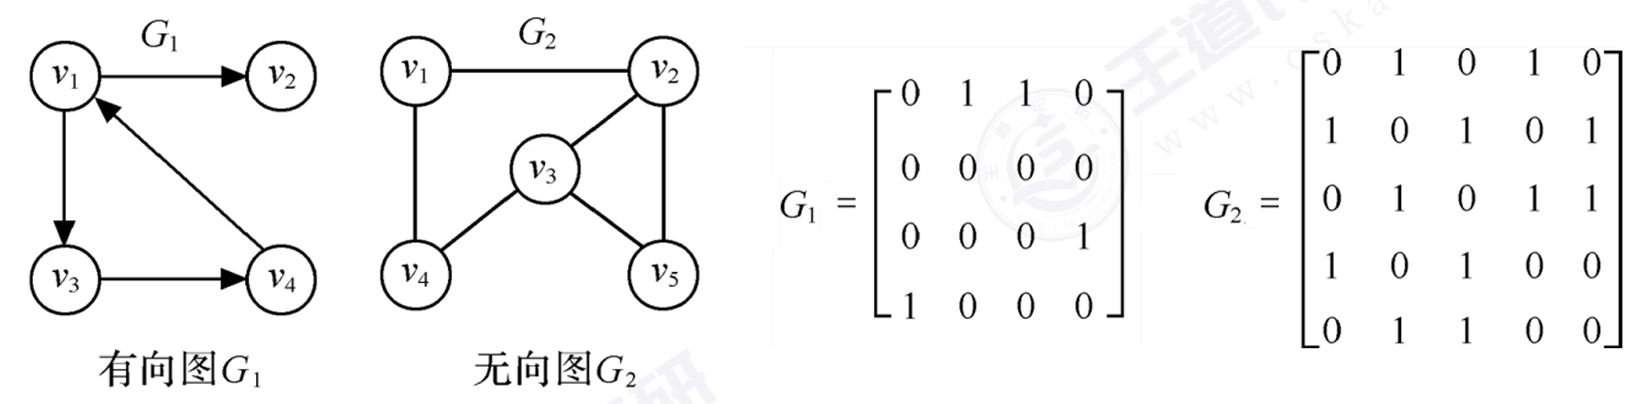
邻接矩阵常使用 0 表示不存在边,Edge[i][j] = 0 说明 i 到 j 之间不存在边。
无权图使用 1 表示边,有权图使用非 0 的数表示存在边。
邻接矩阵结构:
#define MAXV 100                    // 最大顶点数
typedef struct                      // 图的定义
{
    int numVertices, numEdges;      // 图中实际的顶点数和边数
    char verticesList[MAXV];        // 可选:每个顶点名称
    int Edge[MAXV][MAXV];           // 邻接矩阵
} MGraph;
邻接矩阵的遍历:
void TraverseEdges_MGraph(MGraph G)
{
    for (int i = 0; i < G.numVertices; i++)
        for (int j = 0; j < G.numVertices; j++)
            if (G.Edge[i][j] != 0)
                visit(i, j);        // 如果 i→j 存在边则处理
}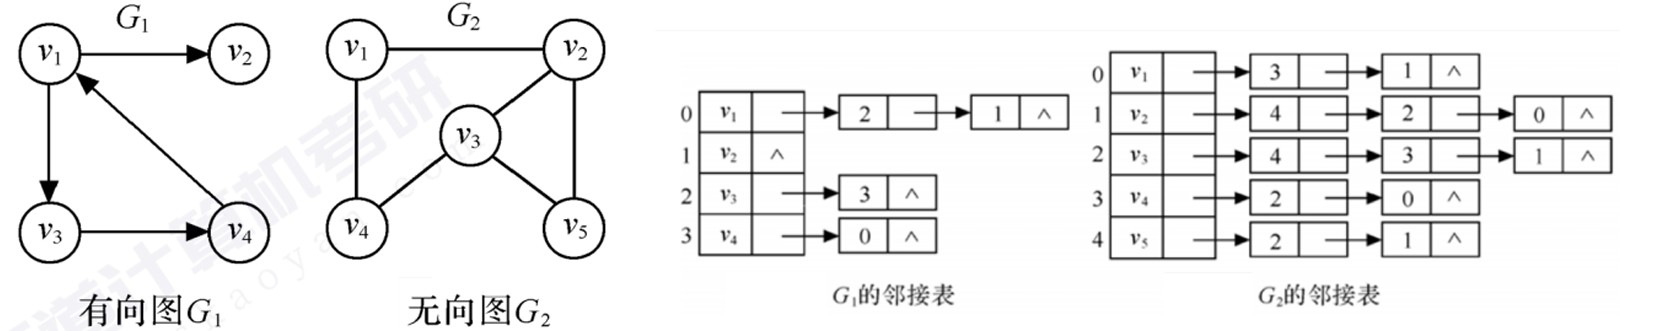
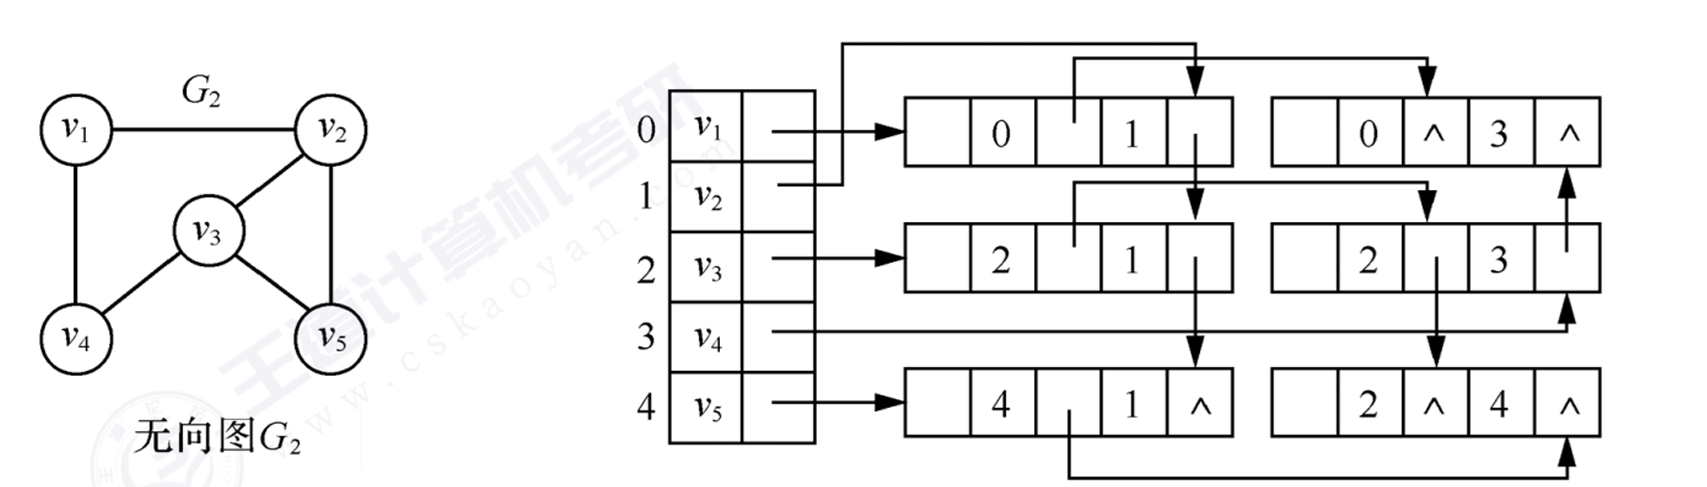
邻接表结构:
#define MAXV 100                    // 最大顶点数

// 边结点
typedef struct ArcNode
{
    int adjvex;                     // 邻接点在顶点表中的下标
    struct ArcNode *next;           // 指向下一条边
    int weight;                     // 有权图可选:边权值
} ArcNode;

// 顶点结点
typedef struct VNode
{
    char data;                      // 可选:顶点信息
    ArcNode *first;                 // 指向第一条邻接边
} VNode;

// 邻接表图定义
typedef struct
{
    VNode verticesList[MAXV];       // 顶点表
    int numVertices, numEdges;      // 顶点数、边数
} ALGraph;VNode 定义中,若我们不需要用到顶点信息,是否可以省略这部分定义?答案是可以的,省略这部分定义可以让邻接表结构更简单,但是该写法可能不太常用:
typedef struct ArcNode
{
    int adjvex;                     // 该弧所指向的顶点
    struct ArcNode *next;           // 指向下一条弧的指针
    int weight;                     // 有权图可选:边权值
} ArcNode;                          // 边结点

typedef struct
{
    ArcNode *verticesList[MAXV];    // 顶点数组
    int numVertices, arcnum;        // 图的当前顶点数和弧数
} ALGraph;
邻接表的遍历:
void TraverseEdges_ALGraph(ALGraph G)
{
    // 遍历所有顶点
    for (int i = 0; i < G.numVertices; i++)
    {
        // 遍历当前顶点 i 发出的所有边
        ArcNode *p = G.VerticesList[i].first;
        while (p != NULL)
        {
            visit(p);               // 访问对应边
            p = p->next;             // 处理下一条边
        }
    }
}
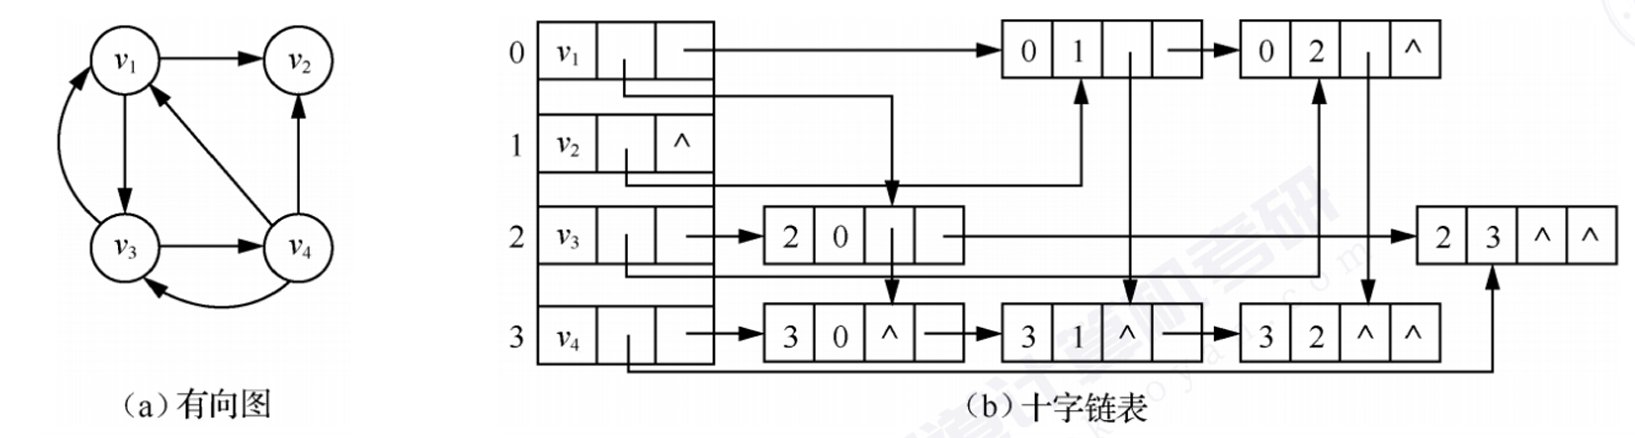
邻接多重表结构:
#define MAXV 100

// 边结点
typedef struct EBox
{
    bool mark;                      // 标记是否访问
    int ivex, jvex;                 // 该边依附的两个顶点下标
    struct EBox *ilink, *jlink;     // 指向 ivex 和 jvex 的下一条边
    int weight;                     // 可选:边权值
} EBox;

// 顶点结点
typedef struct VexBox
{
    char data;                      // 顶点信息
    EBox *first;                    // 指向第一条边
} VexBox;

// 邻接多重表图定义
typedef struct
{
    VexBox VerticesList[MAXV];      // 顶点表
    int numVertices, numEdges;      // 顶点数、边数
} AMLGraph;
邻接多重表的遍历:
void TraverseEdges_AMLGraph(AMLGraph G)
{
    // 遍历所有顶点
    for (int i = 0; i < G.numVertices; i++)
    {
        // 遍历当前顶点 i 发出的所有边
        EBox *p = G.VerticesList[i].first;
        while (p != NULL)
        {
            if (p->mark != true)     // 如果未访问过则访问且标记
            {
                visit(p);
                p->mark = true;
            }
            if (i == p->ivex) p = p->ilink;
            else p = p->jlink;
        }
    }
}
十字链表结构:
#define MAXV 100

// 边结点
typedef struct ArcBox
{
    int tailvex, headvex;           // 弧尾(起点)和弧头(终点)在顶点表中的下标
    struct ArcBox *hlink;           // 指向同终点的下一条边(入边链)
    struct ArcBox *tlink;           // 指向同起点的下一条边(出边链)
    int weight;                     // 可选:边权值
} ArcBox;

// 顶点结点
typedef struct VexNode
{
    char data;                      // 顶点信息
    ArcBox *firstin, *firstout;     // 入边表、出边表指针
} VexNode;

// 十字链表图定义
typedef struct
{
    VexNode VerticesList[MAXV];     // 顶点表
    int numVertices, numEdges;      // 顶点数、边数
} OLGraph;
十字链表的遍历:
void TraverseEdges_OLGraph(OLGraph G)
{
    // 遍历所有顶点
    for (int i = 0; i < G.numVertices; i++)
    {
        // 遍历当前顶点 i 发出的所有边
        ArcBox *p = G.VerticesList[i].firstout;   // 请注意是出边
        while (p != NULL)
        {
            visit(p);               // 访问对应边
            p = p->tlink;            // 起点相同
        }
    }
}💡 基本思想
沿着图的某一路径尽可能「深入」,直到不能继续为止,再回溯到上一个结点,尝试探索其他路径。 其核心是「一条路走到黑,走不通再退回换条路」。类似于树的先序遍历。
⚙️ 实现原理
DFS 的「后进先出」特性天然与栈相配。假设未访问的结点用蓝色,表示平静;已加入递归栈的用橙黄色,表示正在处理中;已处理完的用绿色,表示已经探索完毕。
📝 算法步骤(递归版)
visited[v] = true)。DFS(G, w))。邻接表的 DFS 代码如下:
bool visited[MAXV] = {false};
void DFS_ALGraph(ALGraph G, int v)
{
    visit(v);                              // 访问顶点
    visited[v] = true;
    ArcNode *p = G.VerticesList[v].first;
    while (p != NULL)
    {
        if (!visited[p->adjvex])
            DFS_ALGraph(G, p->adjvex);
        p = p->next;
    }
}

void ans(ALGraph G)
{
    // 无向图调用 DFS 次数等于连通分量数
    for (i = 0; i < G.numVertices; i++)
        if (visited[i] != true) DFS_ALGraph(G, i);
}
若要改成邻接矩阵的 DFS 代码,就是把 void DFS_ALGraph(ALGraph G, int v) 中 while 循环改成 for 循环。
⏱️ 时间复杂度
邻接表:每个顶点和每条边都只会被访问一次,为 O(n+e)。
邻接矩阵:需要遍历矩阵来查找每个顶点的邻接点,为 O(n²)。
💾 空间复杂度
主要取决于递归深度或栈的大小,最坏情况下需要存储所有顶点,为 O(n)。
🎯 应用场景
💡 基本思想
相当于树与二叉树的层次遍历。从一个起始顶点开始,首先访问其所有直接相邻的邻接点,然后按距离逐层向外扩展,访问更远的顶点。 其核心是「逐层扩展,齐头并进」。
⚙️ 实现原理
BFS 的「先进先出」特性需要用队列来实现。假设未扫描的结点用蓝色,表示平静;已加入队列的用橙黄色,表示跃跃欲试待处理;已处理完的用绿色,表示已经探索完毕。
📝 算法步骤
邻接表的 BFS 遍历:
bool visited[MAXV] = {false};               // 表示顶点是否已入队
void BFS_ALGraph(ALGraph G, int v)
{
    int queue[MAXV], front = 0, rear = 0;

    // 1.将 v 入队,标记
    queue[rear++] = v;
    visited[v] = true;

    // 2.如果队列不为空则循环
    while (front < rear)
    {
        // 2-a.选择队头元素 u 访问
        int u = queue[front++];
        visit(u);

        // 2-b.将 u 出发可到达的所有未访问顶点加入队列
        ArcNode *p = G.VerticesList[u].first;
        while (p != NULL)
        {
            if (visited[p->adjvex] != true)
            {
                queue[rear++] = p->adjvex;
                visited[p->adjvex] = true;
            }
            p = p->next;
        }
    }
}

void ans(ALGraph G)
{
    // 无向图调用 BFS 次数等于连通分量数
    for (i = 0; i < G.numVertices; i++)
        if (visited[i] != true) BFS_ALGraph(G, i);
}
⏱️ 时间复杂度
邻接表:每个顶点和每条边都只会被访问一次,为 O(n+e)。
邻接矩阵:同样需要查找每个顶点的所有邻接点,为 O(n²)。
💾 空间复杂度
主要取决于队列的大小,最坏情况下需要存储所有顶点,为 O(n)。
🎯 应用场景
| 特性 | 深度优先遍历(DFS) | 广度优先遍历(BFS) |
|---|---|---|
| 数据结构 | 栈 | 队列 |
| 搜索方式 | 莽夫,无路可走再回溯 | 谨慎,一层层前进 |
| 空间复杂度 | O(n) | O(n) |
| 时间复杂度 | 邻接表 O(n+e),邻接矩阵 O(n²) | 邻接表 O(n+e),邻接矩阵 O(n²) |
| 应用 | 拓扑排序、找环、找连通分量 | 无权图最短路径,二分图 |
| 访问顺序 | 不唯一,取决于邻接点的顺序和起始点 | 不唯一,取决于邻接点的顺序,但层级固定 |
对无权图(或是权值相同的图)来说,最短路径是指从一个顶点到另一个顶点经过的边数最少的路径。 我们可以用 BFS 来寻找最短路径,因为 BFS 按层级遍历图,天然地保证了最先到达某个顶点的路径就是最短路径。
思路:使用 BFS,从源点开始,逐层向外扩展,第一次访问到某个顶点时,所经过的路径就是从源点到该顶点的最短路径。
📝 步骤
dist,dist[start] = 0,所有其他顶点的距离为无穷大 ∞。同时,初始化路径数组 path 用于记录前驱结点。邻接表代码如下,时间复杂度为 O(n+e):
// 使用BFS计算无权图的单源最短路径
void BFS_ShortestPath_AL(ALGraph G, int start)
{
    int queue[MAXV];
    int dist[MAXV], path[MAXV];
    int front = 0, rear = 0;

    // 1.初始化
    for (int i = 0; i < G.numVertices; i++)
    {
        dist[i] = INT_MAX;
        path[i] = -1;
    }

    // 2.将源点入队
    dist[start] = 0;
    queue[rear++] = start;              // 源点入队

    // 3.当队列不为空时,循环执行
    while (front < rear)                // 队列不为空
    {
        // 3-a.队头元素 u 出队
        int u = queue[front++];         // 队头元素出队

        // 3-b.遍历 u 的所有相邻结点 v,如果 v 尚未入队过则将 v 入队并更新距离
        p = G.VerticesList[u].first;
        while (p != NULL)
        {
            int v = p->adjvex;          // 获取邻接点 v 的下标
            // 如果 v 尚未被访问过
            if (dist[v] == INT_MAX)
            {
                dist[v] = dist[u] + 1;  // v 的距离是 u 的距离 +1
                path[v] = u;            // v 的前驱是 u
                queue[rear++] = v;      // 将新访问的顶点 v 入队
            }
            p = p->next;
        }
    }
    // 根据 dist 数组输出长度,根据 path 数组输出路径
}在一个有权图中,我们要求从一个点出发到达其他所有点需要花费的时间。把这个过程想象成在一张地图上找从你家(起点)到所有其他地方的最短花费时间。
1. 准备阶段(初始化)
2. 核心循环(不断寻找下一个最近的地点)
算法会不断重复以下步骤,直到所有地点都被你「确定」下来:
当你把地图上所有能到达的地点都加入了「已确定」集合后,算法就结束了。这时,你清单上记录的就是从你家到每个地点的最短驾车时间。
这个算法的精髓(贪心策略)在于:每次都选择当前看起来最近的那个点,并认定它的最短路径已经找到,然后用它来更新其他邻居点的路径。
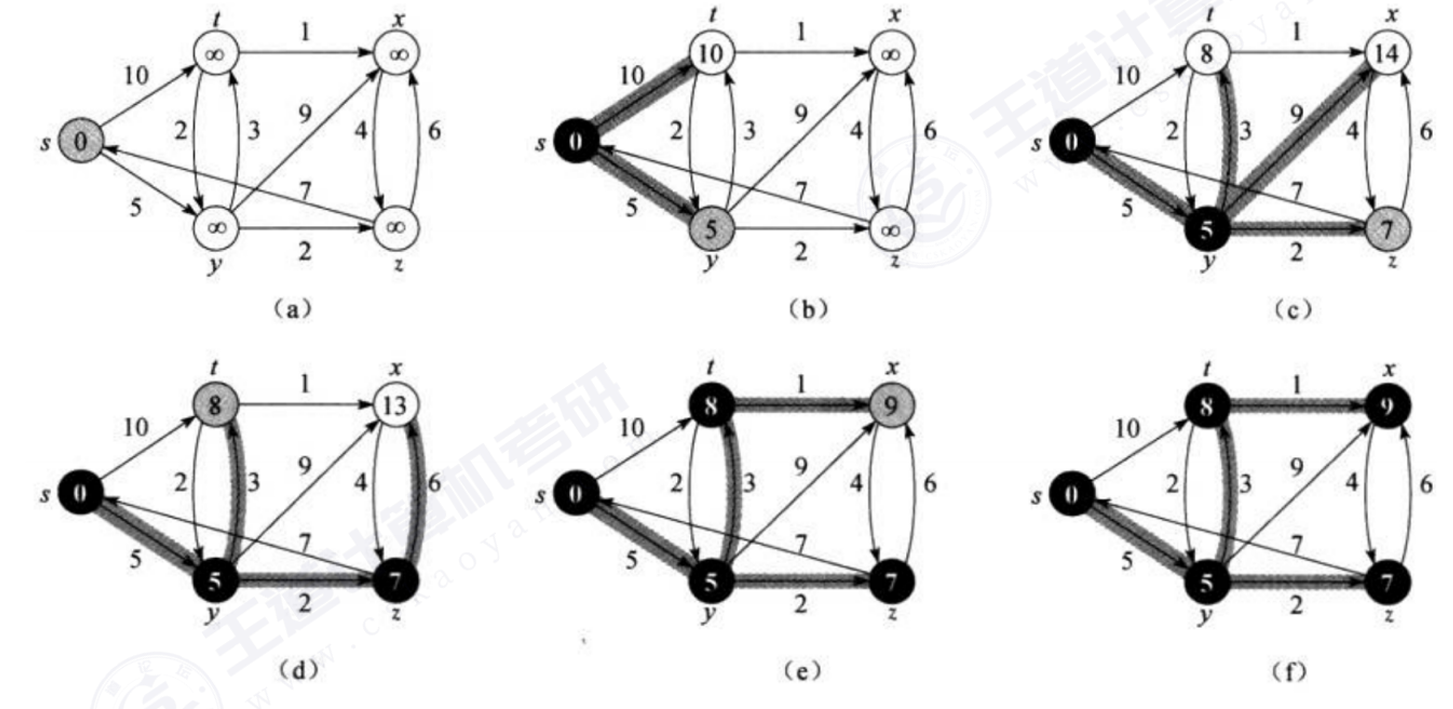
📝 步骤
dist,dist[s] = 0,所有其他顶点的距离为无穷大 ∞。同时,初始化路径数组 path 用于记录前驱结点。dist 最小的、未选择过已确定顶点 u。
u 视为已确定的顶点,之后不再考虑。
u 出发的所有邻接点 v 做松弛:
if (dist[u] + w(u, v) < dist[v])
dist[v] = dist[u] + w(u, v)给定一个连通无向图 G = (V, E),其生成树是:
在所有可能的生成树中,边的权值之和最小的那一棵生成树,称为最小生成树。
有两种算法:Prim 算法和 Kruskal 算法。
核心思想:从顶点的角度出发,初始时已选顶点集合只含起始顶点。每次将一个顶点纳入已选顶点集合,重复 n-1 次直到该集合包含所有顶点。
📝 步骤
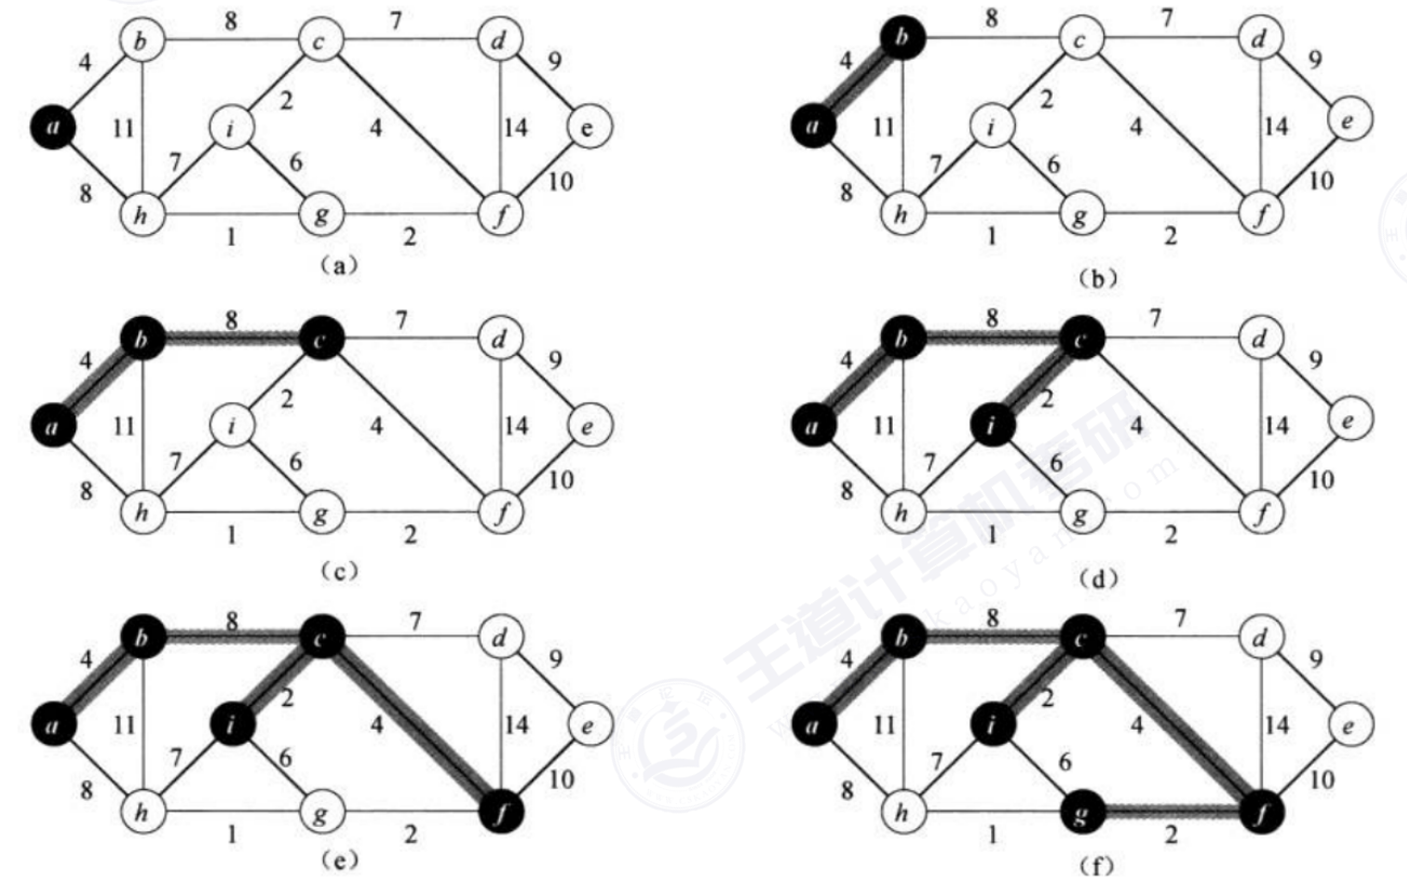
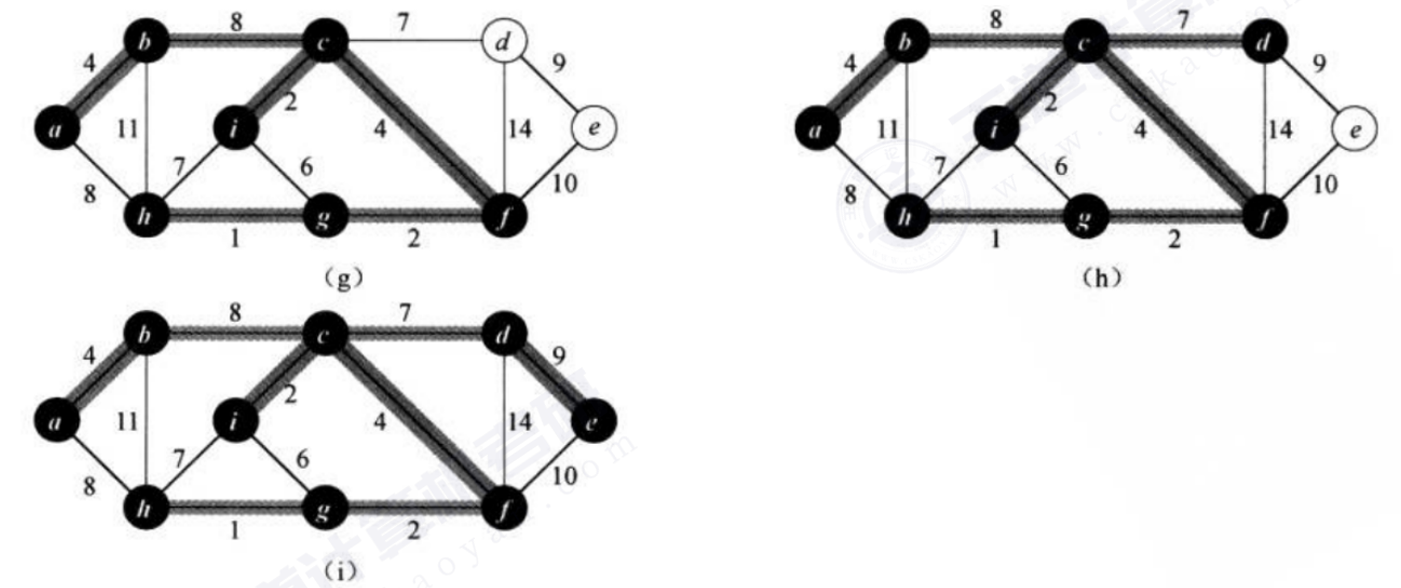
核心思想:从边的角度出发,初始时已选边集合不包含任何边。每次将一条最小的、加入集合后不成环的边纳入已选边集合,重复 n-1 次。
📝 步骤
n-1 条不成环的边:
| 维度 | Prim | Dijkstra |
|---|---|---|
| 选点依据 | 每次从未选顶点中选择距离已选集合最近的点(cost 最小) | 每次从未选顶点中选择距离源点最近的顶点(dist 最小) |
| 记录内容 | cost 记录的是边的长度 | dist 记录的是路径的长度 |
| 更新条件 | cost[j] > w(k, j)(k 距本次选择的顶点 j 比距已选集合中其他顶点更近) | dist[u] + w(u, v) < dist[v](借道 u 之后源点离 v 的距离比借道 u 之前更小) |
| 共同点 | 都是贪心算法,每次选择 xx 最小的;邻接表的写法都可以使用小根堆来优化选择的过程 | |
给定一个用邻接表保存的带权无向图 G,你可以直接调用该函数 ArcNode* FindEdge() 得到一个指针,
指向当前未处理过的边中权值最小的那条边(内部实现细节不需要考虑)。
设计算法 int MSTWeight(ALGraph G) 返回最小生成树的权值之和。邻接表定义如下:
typedef struct ArcNode
{
    int ivex;                       // 该弧起始的顶点
    int jvex;                       // 该弧所指向的顶点
    struct ArcNode *nextarc;        // 指向下一条弧的指针
    int weight;                     // 边权值
} ArcNode;                          // 边结点

typedef struct
{
    int data;                       // 顶点信息
    ArcNode *firstarc;              // 指向第一条依附该顶点的弧的指针
} VNode;                            // 顶点结点

typedef struct
{
    VNode VerticesList[MAXV];       // 顶点数组
    int numVertices, arcnum;        // 图的当前顶点数和弧数
} ALGraph;
问题:
✅ 参考答案
(1)我们需要尽可能快地找出权值最小边,故适合的数据结构是最小堆(Min-Heap),也称优先队列。 原因是把所有边放进最小堆中,在堆顶的永远是当前权值最小的边。而获得最小边的操作(出队)的时间复杂度是 O(log e)。
(2)即 Kruskal 的算法步骤(见上文)。
(3)算法实现:
int father[MAXV];                       // 用于并查集的表示

int Find(int x){                        // 查找根结点
    if (father[x] != x){
        father[x] = Find(father[x]);
    }
    return father[x];
}

void Union(int x, int y){               // 合并两棵树
    int fx = Find(x);
    int fy = Find(y);
    if (fx != fy){
        father[fy] = fx;
    }
}

int MSTWeight(ALGraph G){
    int count = 0;                      // 统计查找次数
    int totalweight = 0;
    for (int i = 0; i < G.numVertices; i++){   // 初始化并查集,初始时所有顶点属于不同集合
        father[i] = i;
    }
    while (count < (G.numVertices - 1)){       // n 个顶点的最小生成树最多有 n-1 条边
        ArcNode *p = FindEdge();        // 通过 FindEdge() 得到最小边
        int rootu = Find(p->ivex);      // 对还未处理的最小边,判断其两个顶点是否在不同的集合里
        int rootv = Find(p->jvex);
        if (rootu != rootv){            // 若在不同集合中,则选择该边,并合并两个顶点所在的集合
            Union(rootu, rootv);
            count++;
            totalweight += p->weight;
        }
    }
    return totalweight;
}🎯 核心目的
| 拓扑序列 | 条件 |
|---|---|
| 存在且唯一 | 每次选择结点时都只有一个结点可选 |
| 存在且不唯一 | 选择结点时不止一个结点可选 |
| 不存在 | 图中有环,环中的顶点未被访问 |
📝 步骤
邻接表的代码,时间复杂度为 O(n+e):
void TopoSort(ALGraph G)
{
    int indegree[MAXV] = {0};

    // 计算每个顶点的入度
    for (int i = 0; i < G.numVertices; i++)
    {
        ArcNode *p = G.VerticesList[i].first;
        while (p != NULL)
        {
            indegree[p->adjvex]++;
            p = p->next;
        }
    }

    // 将所有入度为 0 的顶点入队
    int queue[MAXV], front = 0, rear = 0;
    for (int i = 0; i < G.numVertices; i++)
        if (indegree[i] == 0)
            queue[rear++] = i;

    while (front < rear)
    {
        int u = queue[front++];
        输出顶点 u

        // 此处可判断是否只有一个顶点可选,即 front+1 == rear

        for (ArcNode *p = G.VerticesList[u].first; p != NULL; p = p->next)
        {
            int v = p->adjvex;
            if (--indegree[v] == 0)
                queue[rear++] = v;
        }
    }

    if (rear < G.numVertices)
        拓扑序列不存在,该有向图存在环
}草稿纸上列出流程 → 根据流程在试卷上分块还原代码:
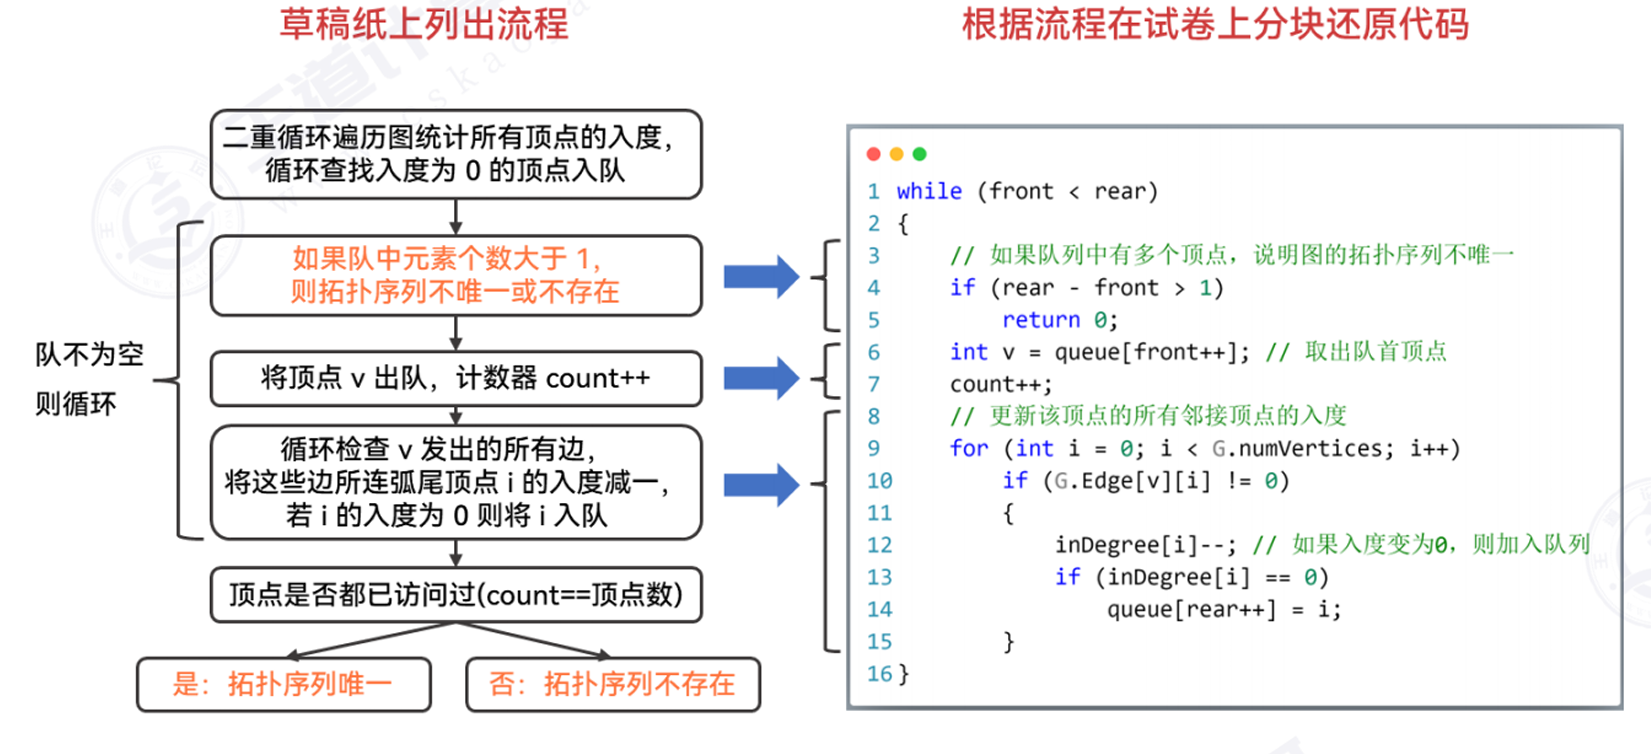
正常情况(无环)下,网中只有一个入度为 0 的点,称作源点;也只有一个出度为 0 的点,称为汇点。
在 AOE 网中,一条路径各弧上的权值之和称为该路径的带权路径长度(简称路径长度)。 要估算整项工程完成的最短时间,就是要找一条从源点到汇点的带权路径长度最长的路径,称为关键路径。
关键路径上的活动叫做关键活动,这些活动是影响工程进度的关键,它们的提前 or 延期将使整个工程提前 or 延期。
🎯 目的
关键路径用于工程调度、项目管理等任务中,找出一条耗时最长的必经路径,控制整个项目进度。
📝 步骤
v_u(e) 等于最迟时间 v_u(l) - w(u,v),则为关键活动。| 方法 | 适用条件 | 时间 | 空间 | 关键点 |
|---|---|---|---|---|
| 暴力枚举 | 无限制 | O(n²) 等 | O(1) | 遍历所有可能 |
| 快速排序 | 可改变下标 | O(n log n) | O(log n) | 不稳定,有使用限制 |
| 折半查找 | 有序表 | O(log n) | O(1) | 两个模板,边界查找用模板二 |
| 散列表 | 数据范围有限 | O(n) | O(m) | 空间换时间,注意初始化 |
| 预处理 | 频繁区间查询 | O(n) + O(1) | O(n) | 前缀和、区间最值 |
| 多指针法 | 线性表(有序为主) | 视情况 | O(1) | 灵魂在「移动规则」 |
| 方法 | 适用条件 | 关键点 |
|---|---|---|
| 暴力枚举 | 无限制 | 一个一个拆下重插,或转数组处理 |
| 多指针法 | 有序链表为主 | 多个有序链表归并 + 快慢指针 + 前后指针 |
| 散列表 | 数据范围有限 | 同顺序表,注意下标范围 |
| 逆置 | 需要反转顺序 | 链表用头插法,顺序表用首尾交换 |
| 头插法/尾插法 | 插入大量结点 | 先连后,再连前。头插逆序,尾插保序 |
| 考点 | 遍历方式 | 关键点 |
|---|---|---|
| 判断叶结点 | 前/中/后序均可 | 不依赖子树信息,全局变量计数 |
| 求树的深度 | 后序 | 自底向上,用函数返回值 |
| 判断完全二叉树 | 层序 | 队列 + 标志位,检查是否连续非空 |
| 判断 BST | 中序 | 中序递增,用 pre_value 比较 |
| 判断 AVL | 后序 | 求子树高度 + 返回 -1 标记不平衡 |
| 并查集 | — | find 路径压缩 + Union 合并,双亲表示法 |
| WPL 带权路径长度 | 先序/后序/层序 | 全局变量累加 or 函数返回值,层序用 front/rear/last |
| 考点 | 适用结构 | 时间 | 关键点 |
|---|---|---|---|
| 邻接矩阵 | 有向/无向图均可 | 遍历 O(n²) | 0 表示无边,无权图用 1、有权图用非 0 数表示有边 |
| 邻接表 | 有向/无向图均可 | 遍历 O(n+e) | 类似孩子表示法;顶点信息可省略以简化结构 |
| 邻接多重表 | 仅无向图 | — | 考察概率低,了解即可;mark 标记边是否访问 |
| 十字链表 | 仅有向图 | — | 考察概率低,了解即可;分 firstin / firstout 出边入边链 |
| DFS | 邻接表 / 邻接矩阵 | O(n+e) / O(n²) | 栈(递归);找连通分量、检测环路、拓扑排序;空间 O(n) |
| BFS | 邻接表 / 邻接矩阵 | O(n+e) / O(n²) | 队列;无权图最短路径、检测二分图;空间 O(n) |
| 单源最短路径 | 无权图用 BFS | O(n+e) | dist 记距离、path 记前驱;先访问到的即为最短 |
| Dijkstra | 有权图(非负权) | — | 贪心;考察代码概率极低,重点手工模拟;松弛 dist[u]+w < dist[v] |
| Prim | 最小生成树 | — | 从顶点出发;cost 记录边的长度 |
| Kruskal | 最小生成树 | O(e log e) | 从边出发;最小堆取最小边 + 并查集判环 |
| 拓扑排序 | 有向无环图 DAG | O(n+e) | 统计入度,入度为 0 入队;出队时后继入度减 1;有未访问顶点则有环 |
| 关键路径 | AOE 网(带权无环图) | — | 拓扑序正推 v(e) + 逆推 v(l);v(e) == v(l) - w 即为关键活动 |
整理自桌面「算法题.docx」· 更新于 2026-09-30 · 考研 408 自学笔记